

Ведутся технические работы. Это может временно повлиять на скорость работы сайта. Приносим извинения за неудобства и благодарим за ваше понимание!
acf domain was triggered too early. This is usually an indicator for some code in the plugin or theme running too early. Translations should be loaded at the init action or later. Please see Debugging in WordPress for more information. (This message was added in version 6.7.0.) in /home/user/web/mal.scrum360.ru/public_html/wp-includes/functions.php on line 6260cyr2lat была запущена слишком рано. Обычно это индикатор того, что какой-то код в плагине или теме запускается слишком рано. Переводы должны загружаться при выполнении действия init или позже. Дополнительную информацию можно найти на странице «Отладка в WordPress». (Это сообщение было добавлено в версии 6.7.0.) in /home/user/web/mal.scrum360.ru/public_html/wp-includes/functions.php on line 6260Ведутся технические работы. Это может временно повлиять на скорость работы сайта. Приносим извинения за неудобства и благодарим за ваше понимание!


Программное обеспечение для генерации глубоких подделок (основанный на искусственном интеллекте метод синтеза человеческого изображения) требует больших наборов изображений для создания реалистичной подделки. Последние достижения в области нейронных сетей показали, насколько высоко реалистичные человеческие изображения могут быть получены путем обучения сети широкому кругу наборов данных.
Однако разработчики в исследовательском центре Samsung в Москве уже разработали новую модель искусственного интеллекта (AI), которая может создавать говорящие аватары из одного изображения. Несмотря на то, что можно изготовить видеоклип из одного изображения, его тренировка по нескольким изображениям позволяет лучше идентифицировать сохранение и повысить реалистичность.
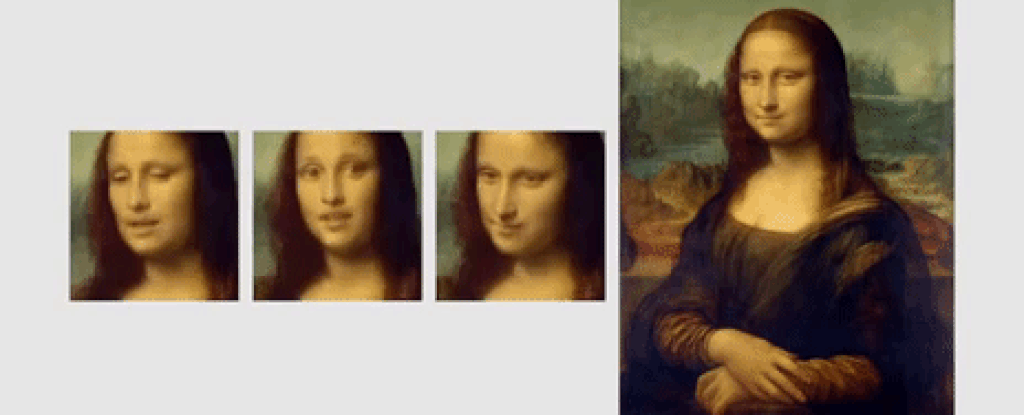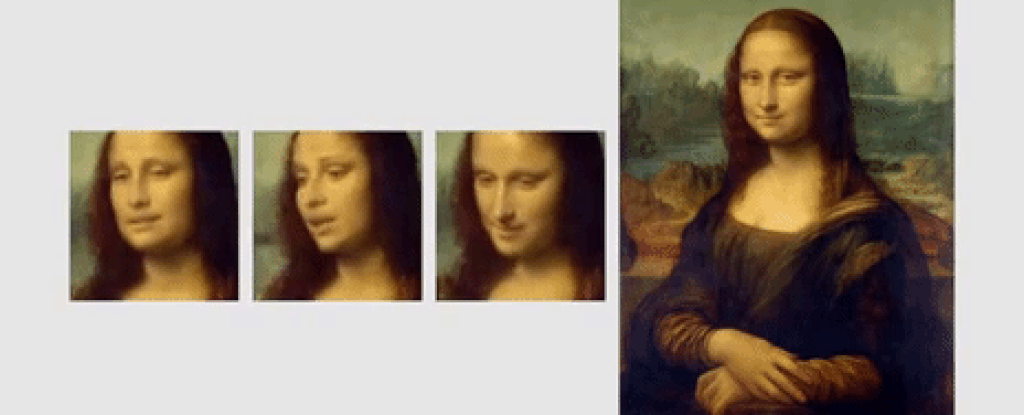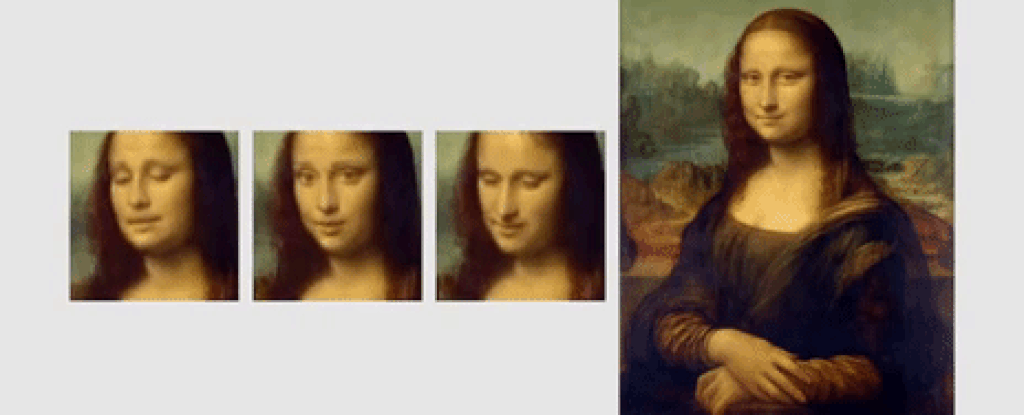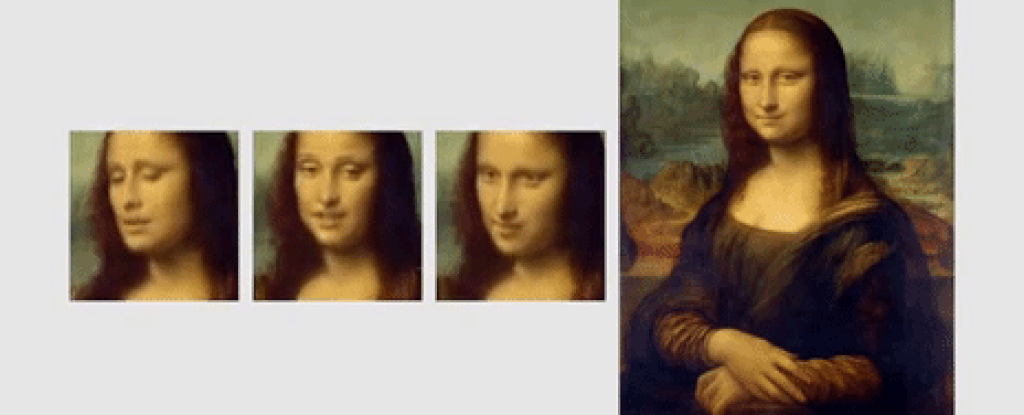
Говорящие головы, генерируемые этой моделью, могут принимать различные позы, в том числе те, которые выходят за рамки возможностей систем, основанных на деформации. Вы можете найти некоторые визуальные глюки, но результаты намного впечатляют по сравнению с предыдущими методами. Модель приводит к созданию мультимедиа, которое в конечном итоге будет трудно отличить от реального видео.
Изготовление реалистичных последовательностей говорящих аватаров затруднено в основном по двум причинам:
Чтобы решить эти проблемы, новая модель ИИ создает 3 нейронные сети в процессе обучения. Он строит встроенную сеть, которая соединяет рамки ориентира лица с векторами. Затем он строит сеть генераторов для сопоставления ориентиров в синтезированные клипы. На последнем этапе сеть дискриминатора оценивает позу и реализм кадров.
Чтобы лучше понять ориентиры и движения лица, исследователи обучили сети на тысячах видео YouTube, на которых люди разговаривают. Затем результаты (говорящие головы) сравнивали с альтернативными нейронными сетями с помощью количественных измерений.
Команда применила эту модель на изображениях многих популярных фигур, таких как Мона Лиза, Леонардо да Винчи и Альберт Эйнштейн. ИИ смог изготовить говорящее видео из одного изображения, воплотив в жизнь классические портреты. Для создания видео нужна только одна фотография. Тем не менее модель, обученная на 32 фотографиях, может достичь лучшего результата персонализации и идеального реализма.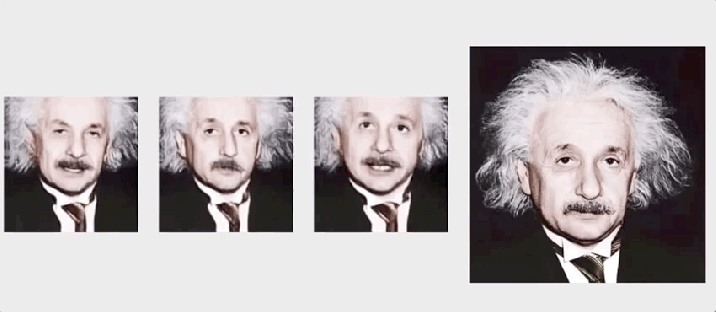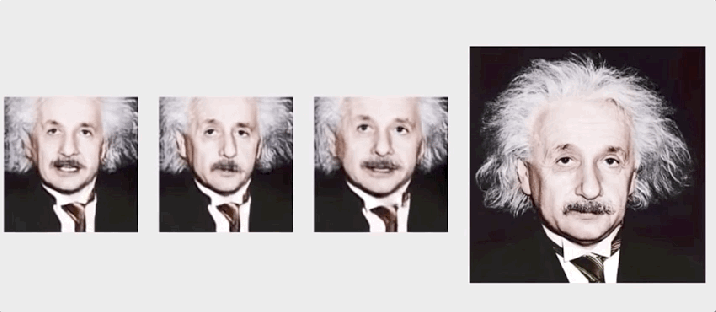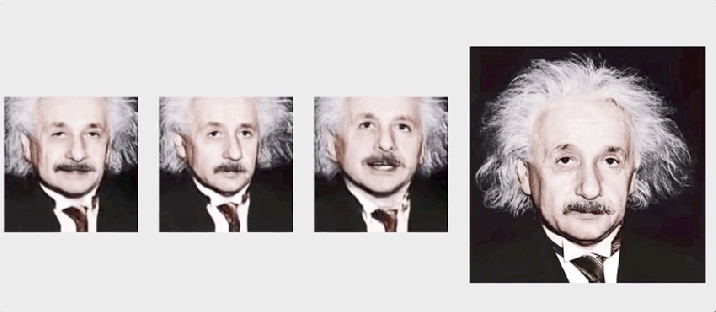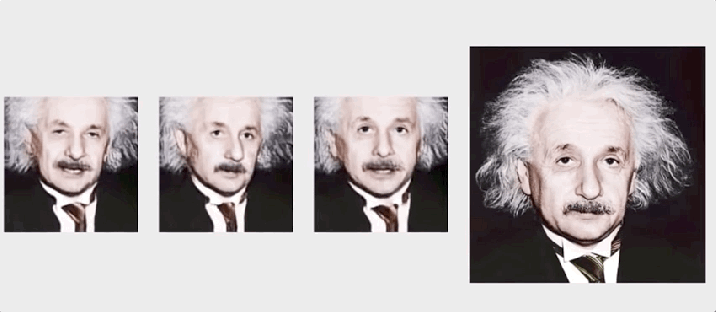
Этот тип ИИ может иметь несколько практических применений в телеприсутствии, включая многопользовательские игры, видеоконференции, а также индустрию спецэффектов.
С другой стороны, быстрое развитие таких методов может повысить риск дезинформации, подделки, и мошенничества.